文档总是在 PR 之后变乱
最近 Vibe Coding 用得越来越多,我发现文档维护反而成了一个很容易被忽略的环节:AGENT.md、PRD.md、CHANGE_LOG.md 都需要人手同步。
即使可以通过 Hook,或在 Code Review 时用 AI 更新这些文档,仍会面临一些问题:
- 风格不统一:有人写「修复了 xxx 问题」,有人写「fix: xxx」,同一个项目的 Changelog 像拼凑出来的。
- 规范靠自觉:Skill 文件、模板都有,但每个人的 AI Prompt 不一样,执行效果参差不齐。
- PR 合并后才暴露问题:合入前各自写各自的文档看不出问题,合入后文档拼在一起才发现格式打架。
所以,其实缺的不是「有人写文档」,而是「有统一的机制在提 PR 后把关」。
于是我做了一个小 Bot:新建 PR 时,让同一个 Agent 按同一套规范、在同一次调用里更新所有需要变更的文档。
我为什么没有只写一个 CI 脚本
CI 能做到的是「PR 新建 → 触发脚本」。但文档更新不是简单的规则映射:
- 不是「改了文件 A → 更新文档 B」的固定规则。
- 需要理解变更语义:这是新功能还是 Bug 修复?影响了哪些章节?
- 需要遵循项目规范:Changelog 用什么格式?PRD 用什么结构?增量追加还是覆盖?
这些都需要 LLM 的语义理解能力,并非 CI 脚本能够独立完成。
因此最终方案是:Gitee Webhook 触发 + LLM Agent 理解变更 + Skill 文件约束规范。
先在回演项目里跑了一遍
目前已应用在 CueCast 回演项目中:
PRD.md:自动追加变更日志行,并定点更新受影响的功能点和需求。docs-site/changelog.md:按月份归档更新日志。
效果是:PR 新建后自动触发一次 Commit 更新文档,始终保持同一种口吻、同一种格式、同一套规范。
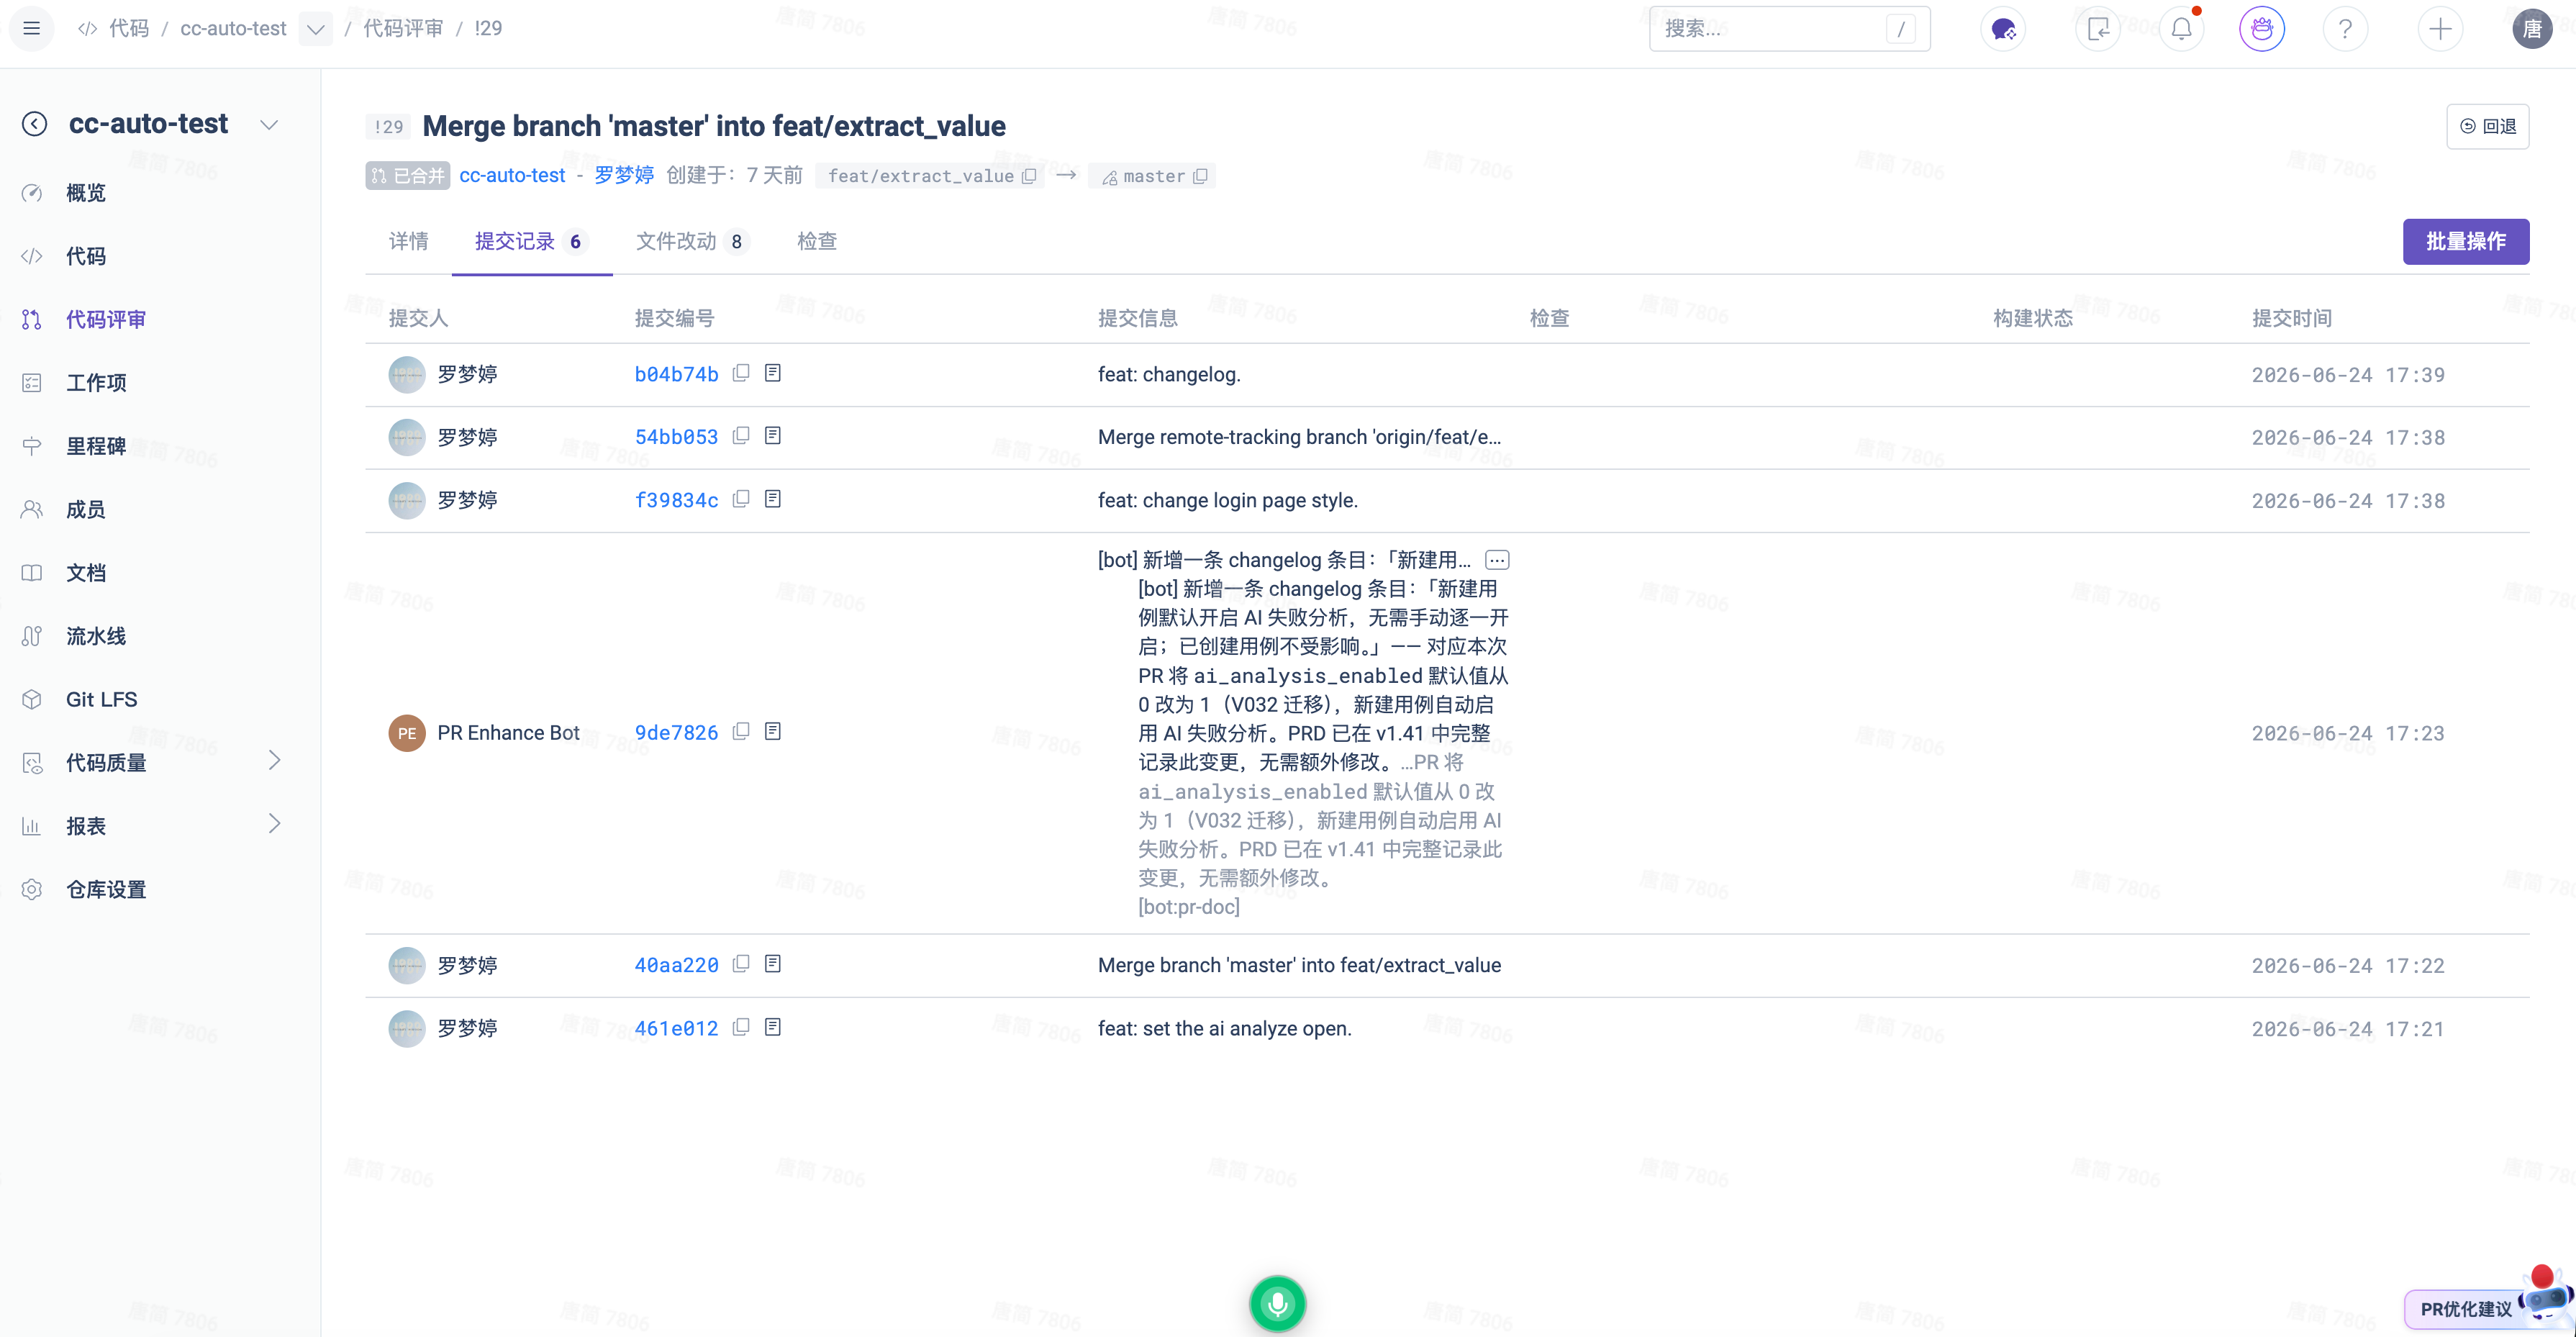
下图是 Bot 在 PR 中自动提交 Changelog 更新后的记录:
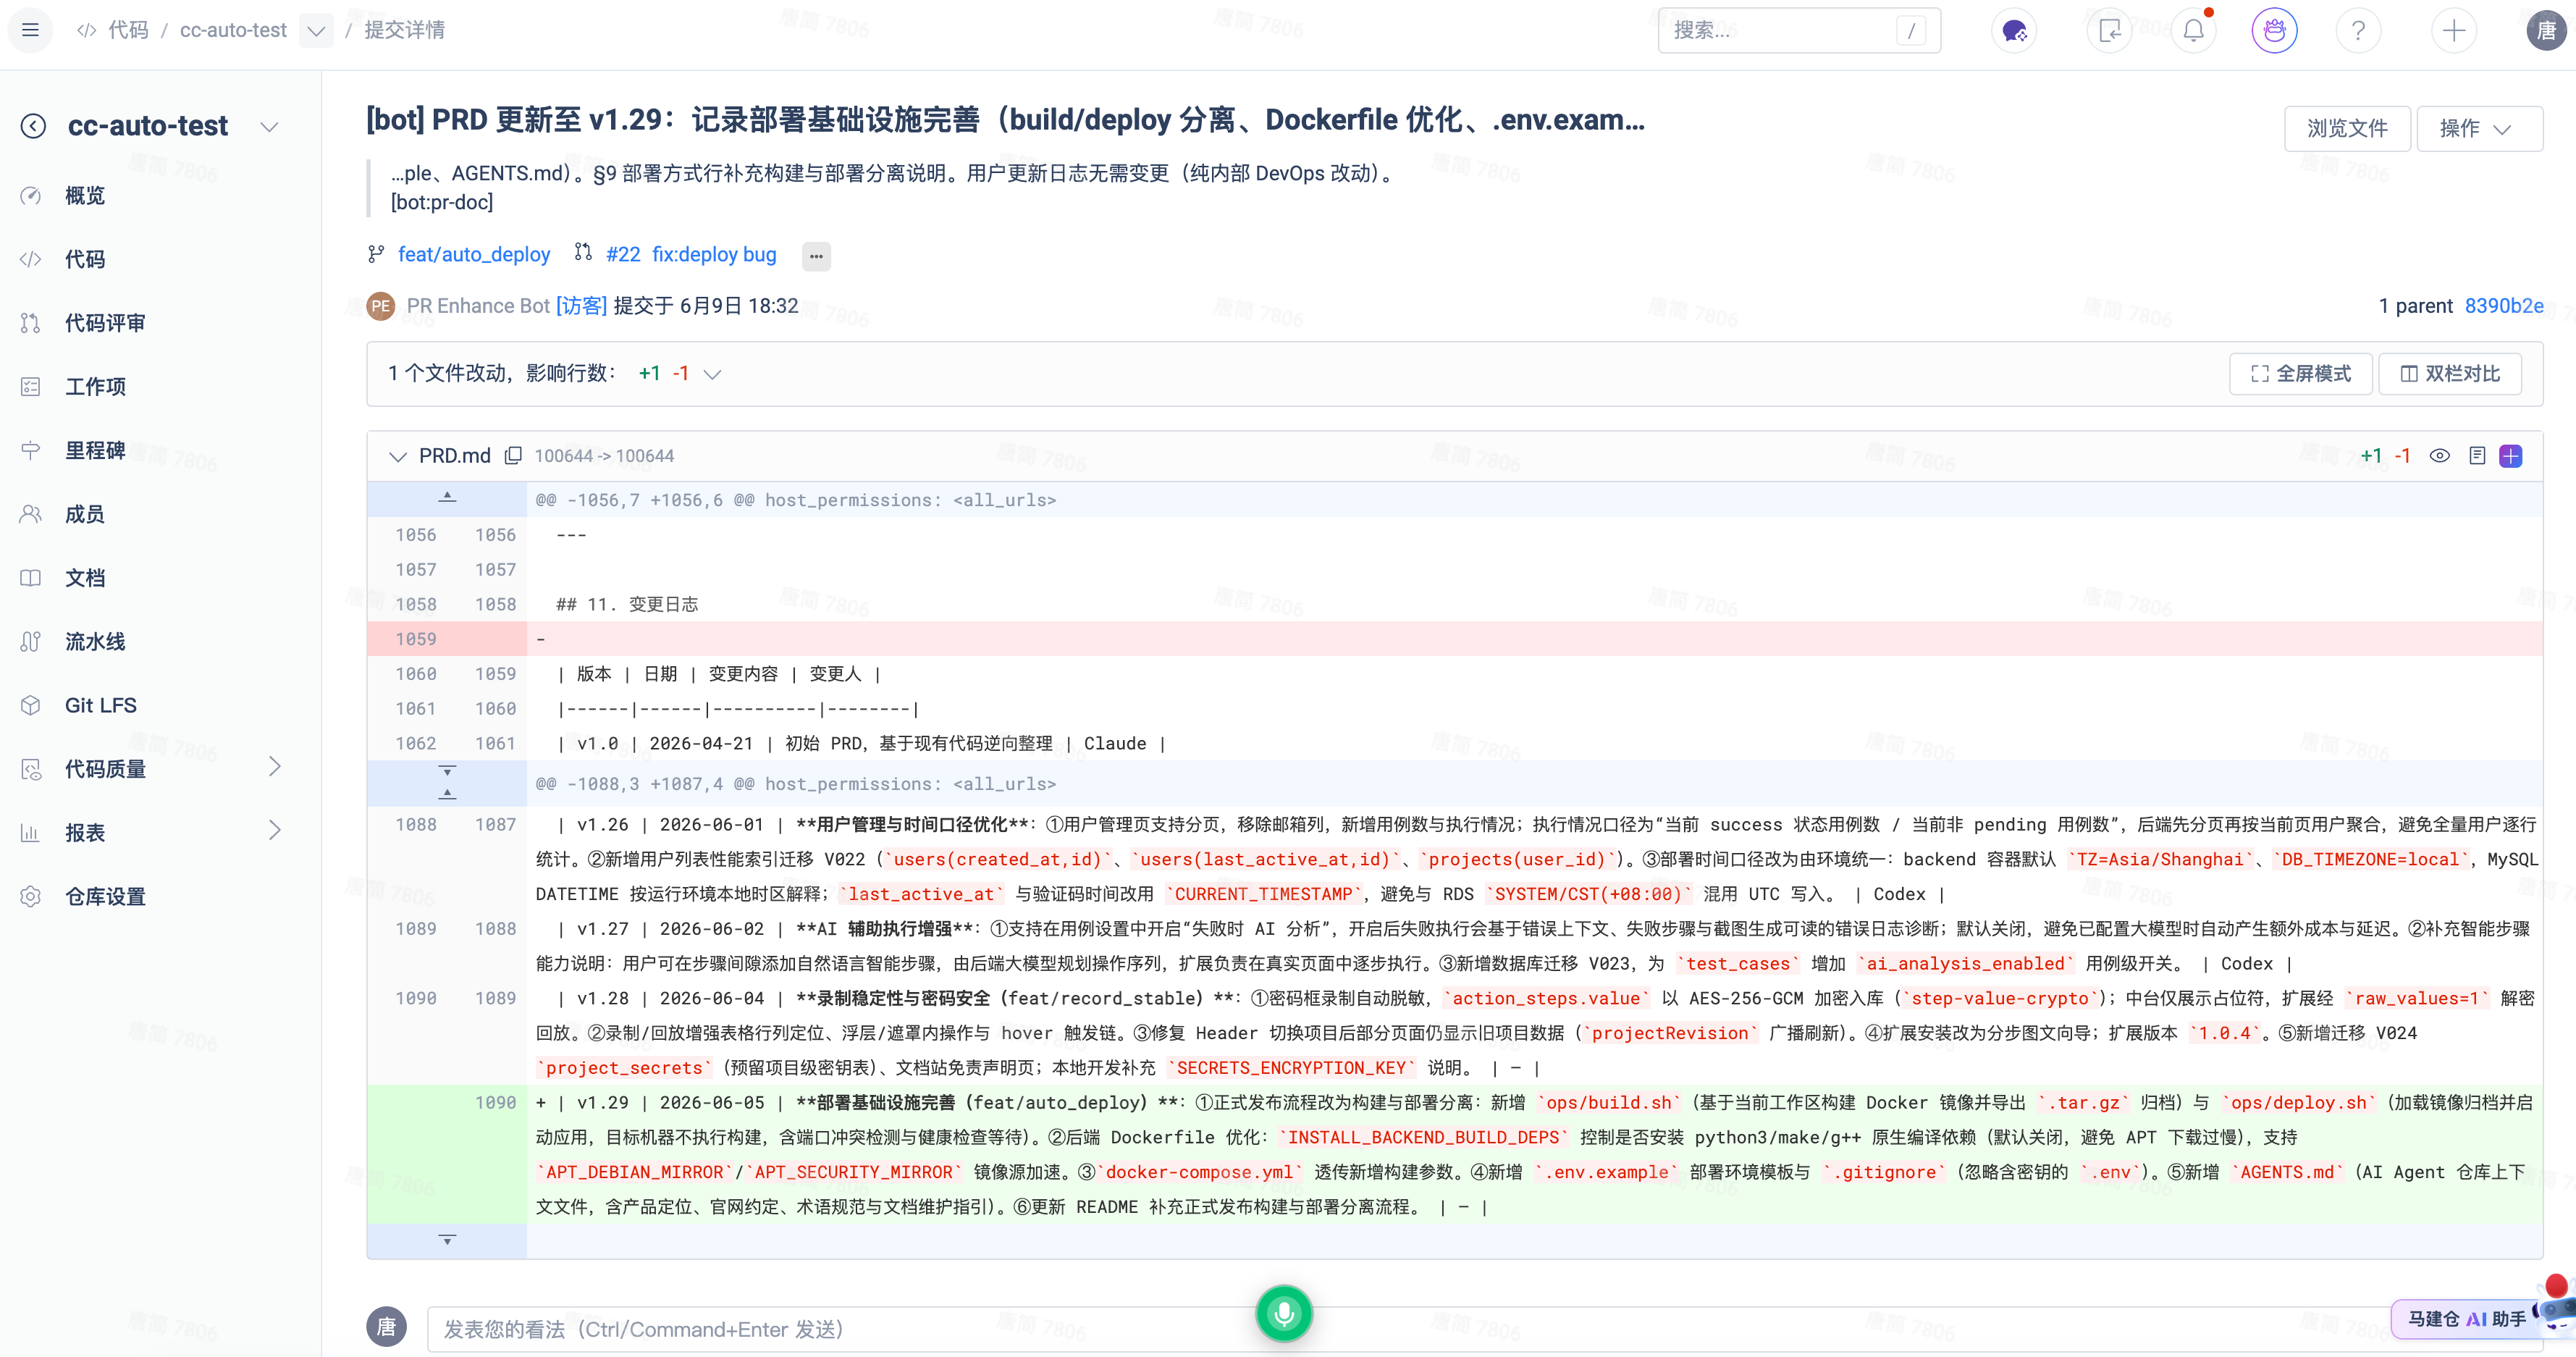
PRD 的变更会被精确追加到变更日志章节,而不是覆盖或打散原有内容:
如果你也想试试
① 配置 Gitee Webhook
在 Gitee 仓库中新增 Webhook,并配置与 Bot 一致的回调地址和密码。
② 在中台配置参数
访问 Admin 管理后台,在「路由配置」中填写:
| 配置项 | 说明 |
|---|---|
GITEE_TOKEN |
Gitee 私人令牌,用于 clone / push。 |
GITEE_WEBHOOK_SECRET |
Webhook 密码,需要与 Gitee 侧配置保持一致。 |
DEEPSEEK_API_KEY |
LLM API Key。 |
job.repo |
目标仓库,例如 clougence/cc-auto-test。 |
rules.actions |
触发动作,例如 [open, update]。 |
rules.targetBranches |
目标分支,例如 [master, main]。 |
allowedPaths |
允许 Bot 修改的文件白名单。 |
也可以直接编辑 config/bot.yaml;配置修改即时生效,无需重启服务。
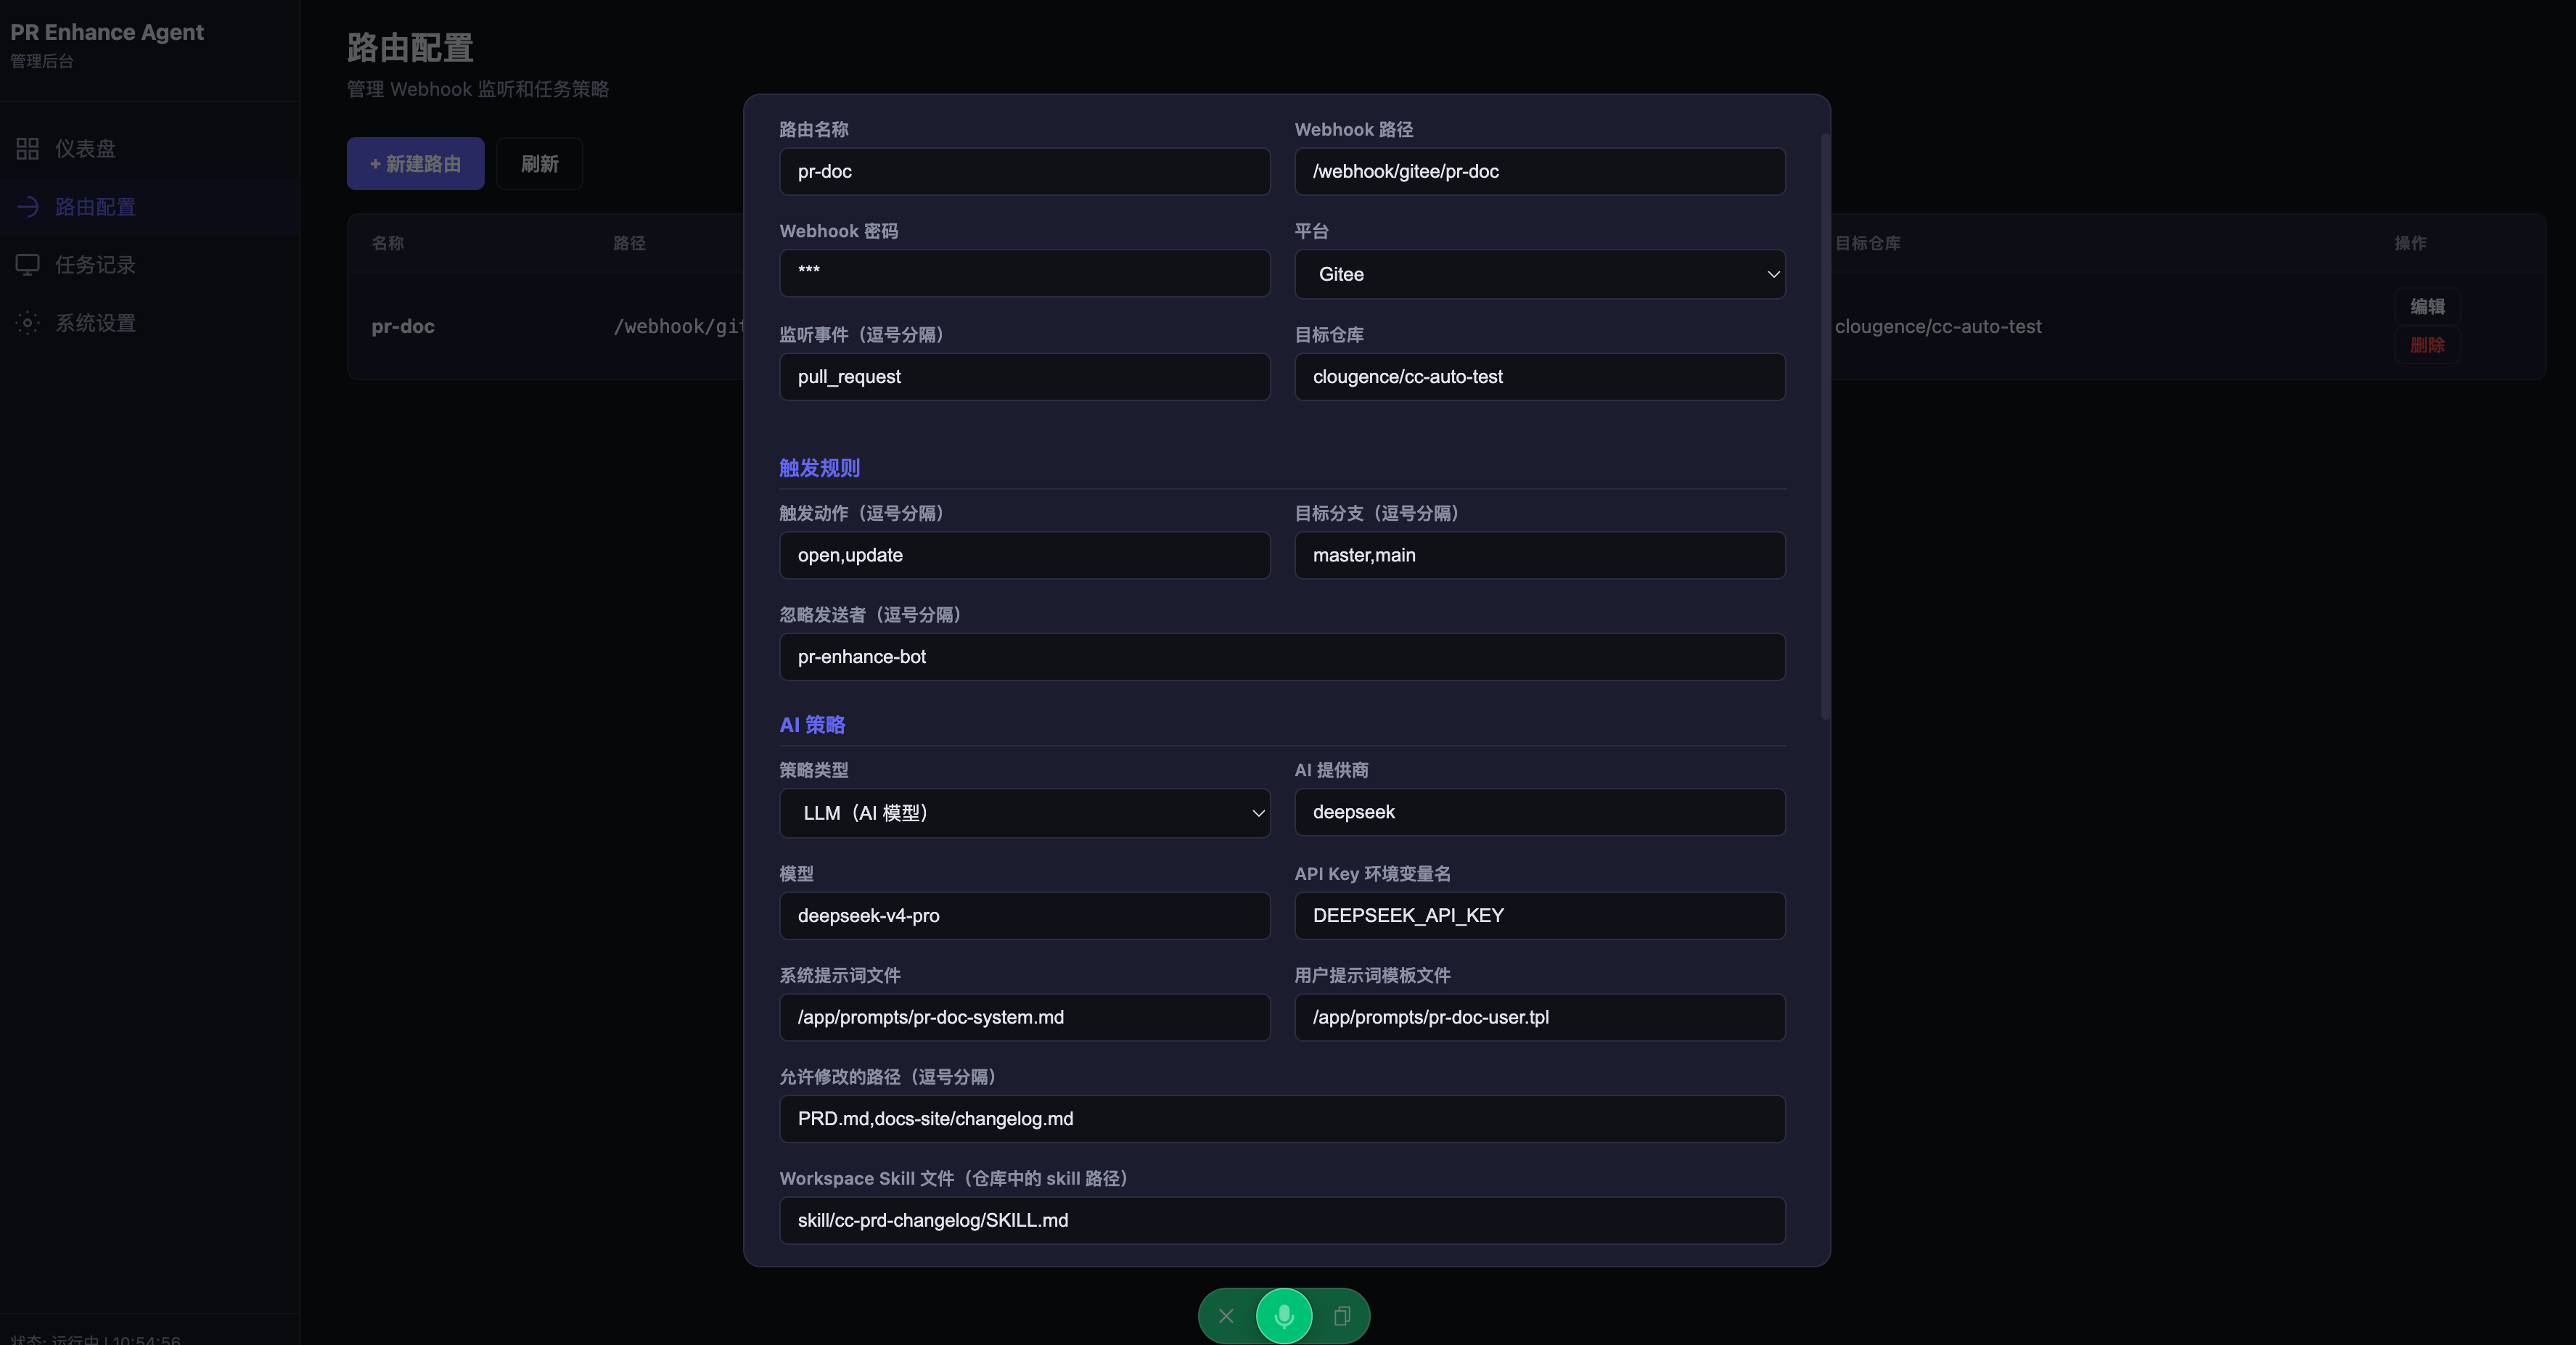
下图展示了路由、触发规则、模型、允许修改的文件和 Workspace Skill 路径等配置项:
③ 配置 Skill 路径
在目标仓库中放置 Skill 文件,例如 skill/cc-prd-changelog/SKILL.md,用于定义 Changelog 格式、PRD 章节结构、增量追加规则等。随后在路由配置中指定该文件路径。
Bot clone 仓库后会自动读取 Skill 并注入 System Prompt。因此,修改文档规范只需要更新 Skill 文件,不需要修改 Bot 代码。
这个 Bot 是怎么工作的
整体链路如下:开发者新建或更新 PR 后,Gitee 推送 Webhook;Bot 验签、排队并获取代码变更,LLM 按需读取信息后生成结构化修改指令,最后由 Bot 写入文档、提交并回写 PR 评论。
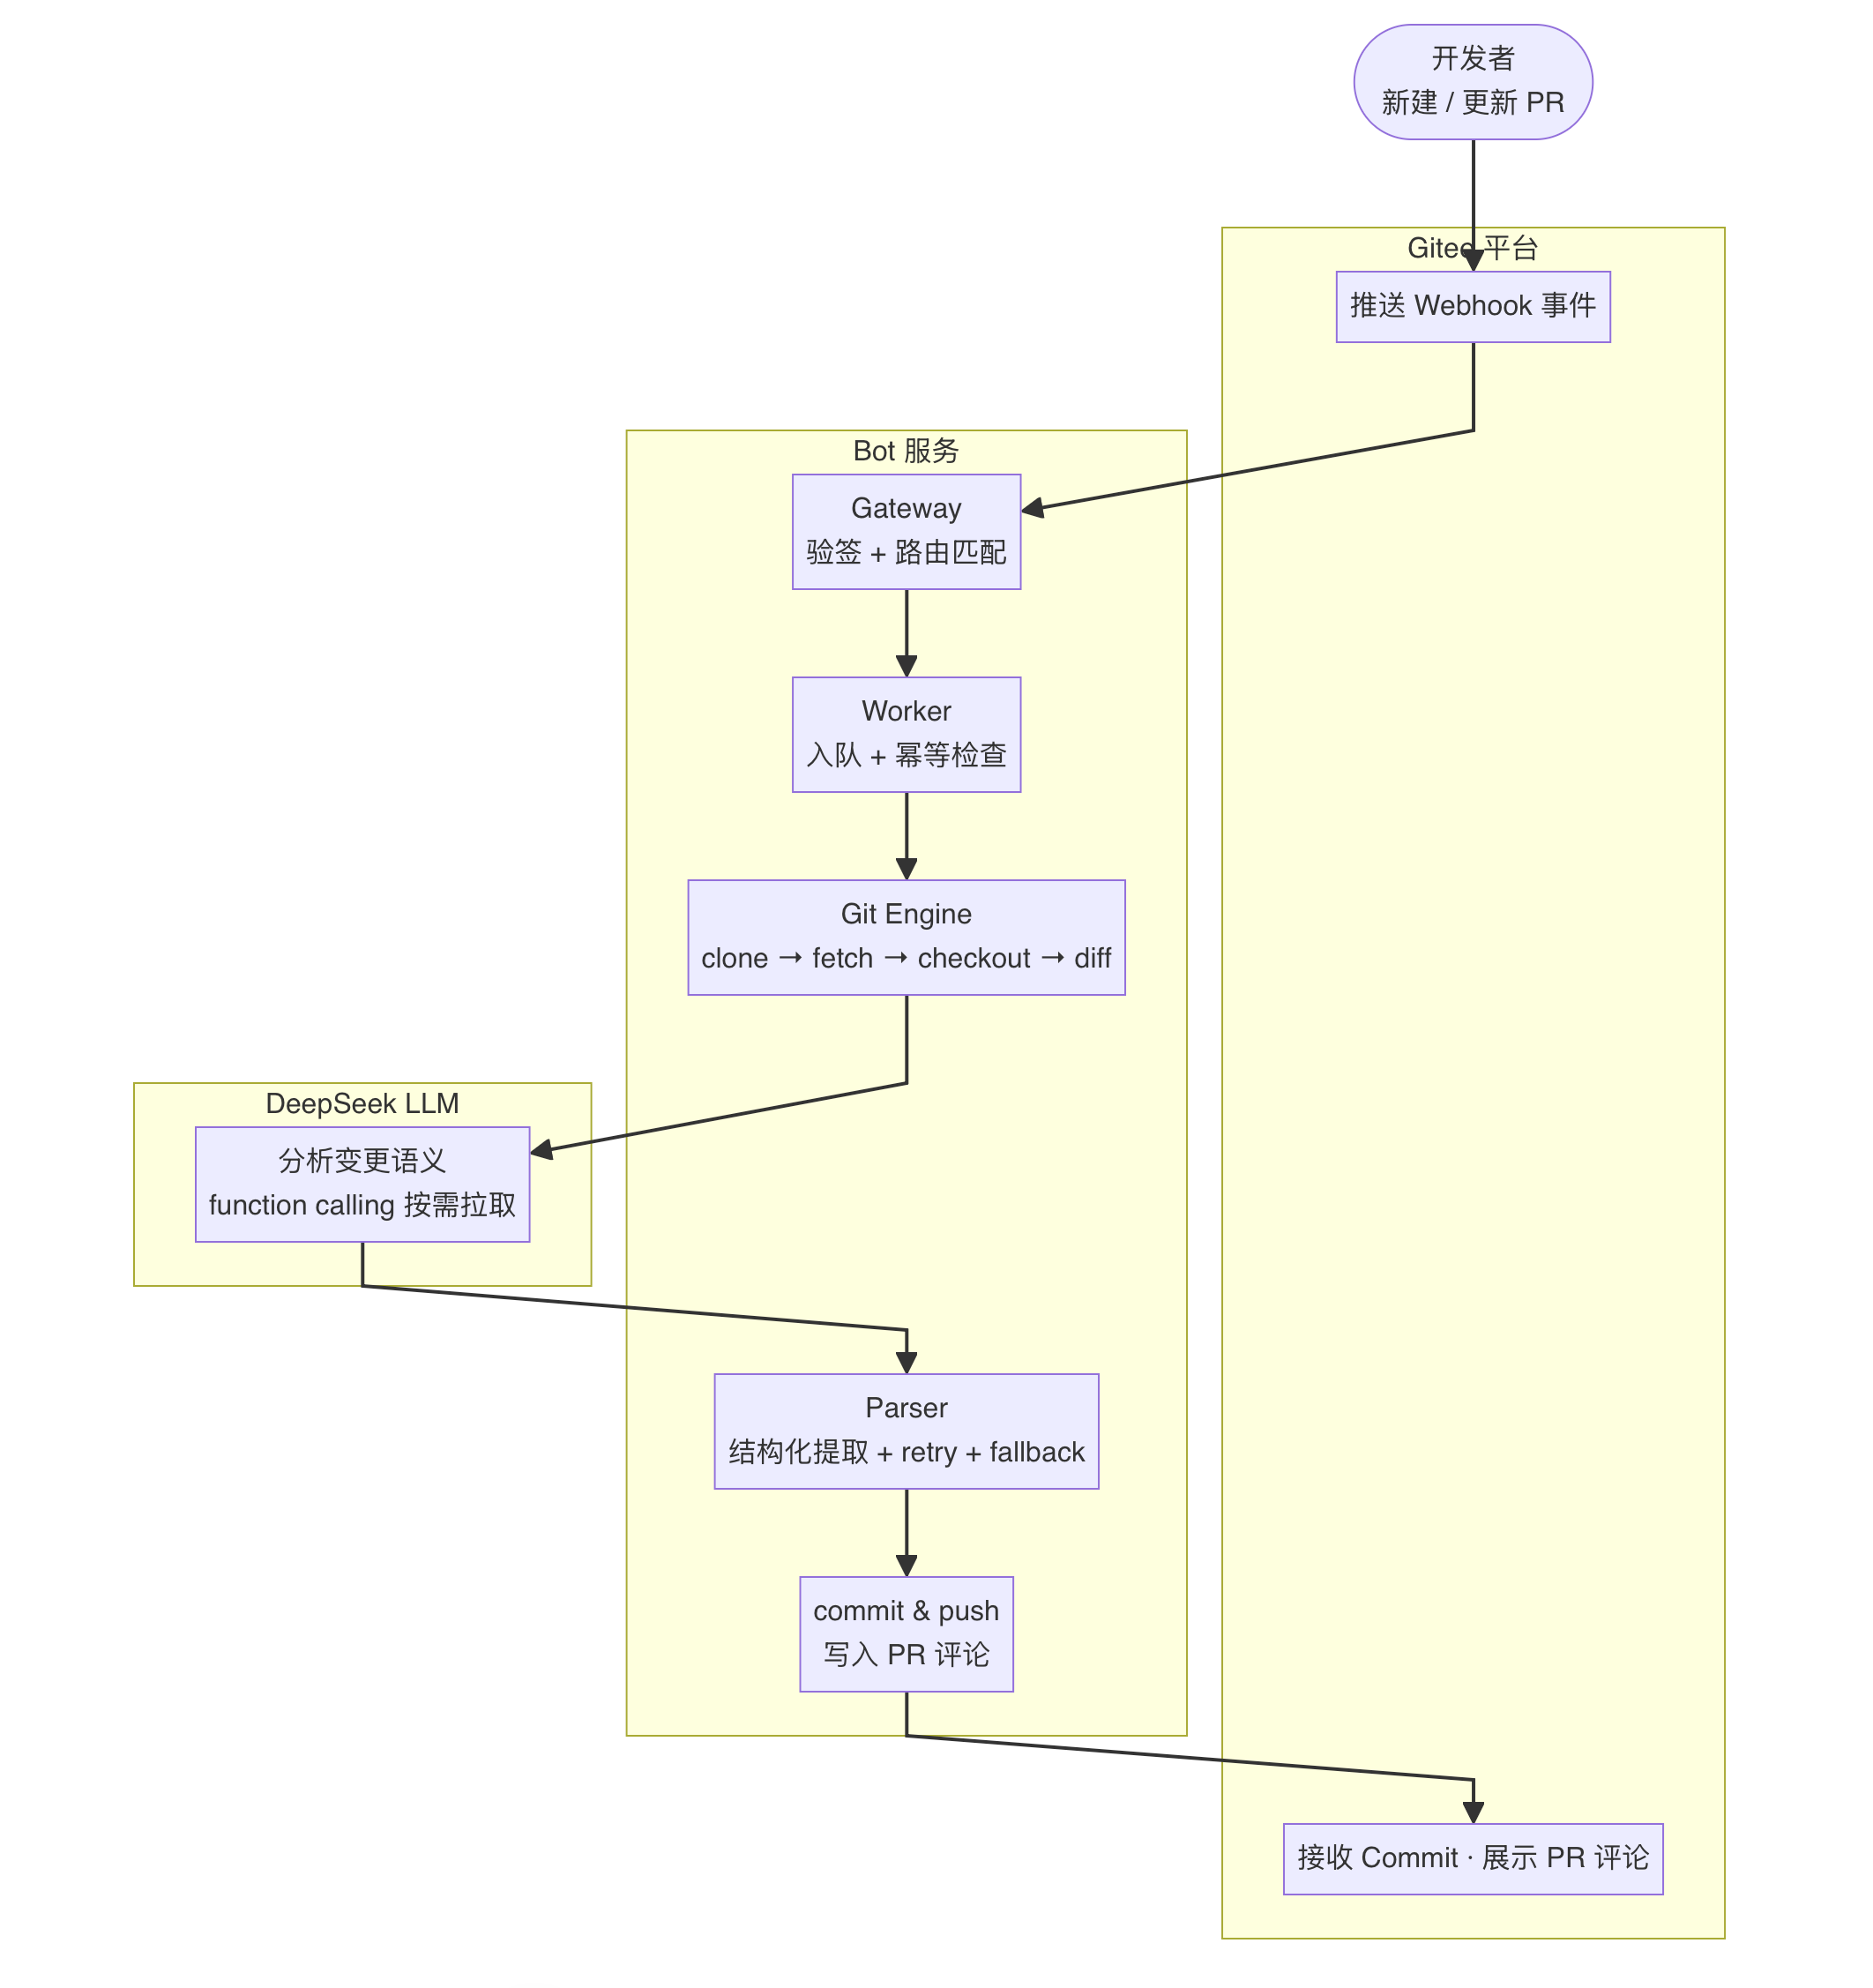
5.1 整体流程
| 模块 | 职责 |
|---|---|
| Gateway | Webhook 入口。校验 Gitee 请求签名、过滤非法请求;按仓库和事件类型做路由匹配,确认该 PR 是否需要 Bot 处理。 |
| Worker | 任务调度中心。将 Gateway 通过的事件写入队列异步执行;进行幂等检查,同一 headSha 不重复处理,避免 Webhook 重试或并发触发多次文档更新;同时负责文件读写、Commit 与 Push。 |
| Git Engine | Git 操作引擎。负责 clone、fetch、checkout、diff 等确定性操作;并为 LLM 的 Function Calling 提供 get_diff / read_file 数据源。 |
| Parser | LLM 输出解析层。将模型返回的自然语言转换为结构化文档修改指令;解析失败时逐层降级,最终返回明确错误,不静默跳过。 |
5.2 Function Calling:从准备到输出
Function Calling 是给模型注册一组可调用的工具。模型在推理过程中可以主动决定调用哪个工具,以及传入哪些参数。
它能避免一开始就塞入巨大的 Prompt。模型可以先根据 PR 标题和变更文件列表,判断后续是否需要查看具体改动。例如,若只是更新 package-lock.json,可以直接输出 ACTION: no_change。
准备 Prompt
初始 User Prompt 只包含 PR 元数据:标题、分支、变更文件列表;不包含 Diff 和文档正文。模型按需通过工具拉取所需内容。
定义工具
提供两个 OpenAI-compatible Function:
get_diff:返回 Worker 预生成的 Diff。read_file:从 Workspace 读取文件内容。
调用循环
最多执行 5 轮调用。LLM 返回 tool_calls 时,Bot 执行工具,并将结果以 role: "tool" 追加回 messages。最后一轮强制设置 tool_choice: "none",确保模型输出纯文本的最终结果。
5.3 Parser:解析、降级与文档修改
LLM 最终输出的是一段文本,Bot 需要把它转换为可执行的结构化指令:修改哪个文件、哪个章节、替换成什么内容,再合并进现有文档。Parser 就是完成这件事的。
规定输出格式
System Prompt 要求 LLM 按固定 delimiter 格式输出。例如:
1 | ACTION: patch |
如果无需修改,则返回:
1 | ACTION: no_change |
主解析器 parseOutput
主解析器用正则逐层提取:
- 读取第一行的
ACTION: patch或ACTION: no_change,决定后续路径。 - 用
---FILE: 路径 ---与---END---切出每个文件块。 - 在每个文件块中,用
HEADING:与CONTENT:切出需要修改的章节。
解析成功后,Parser 得到结构化指令,并交给 Worker 合并文件。
解析失败时的降级
LLM 有时会不按格式返回,或直接给出 Markdown Code Block。Parser 按以下顺序逐步降级:
- 让 LLM 自己重格式化:将原始输出与
CORRECTION_PROMPT(例如「你上次格式不对,请严格按 ACTION/FILE/HEADING 格式重新输出」)发回给模型,以temperature=0再调用一次,再对新回复执行parseOutput()。 - 从自然语言里硬提取:若重试后依然格式不正确,则执行
parseNaturalLanguage()。它会匹配「no changes needed」「无需修改」等中英文句式;也会在allowedPaths白名单中匹配被提及的文件名,再从 Markdown Code Block 里按##标题切出heading与content,拼成 Patch 结构。 - 明确报错:三级都失败时返回
action: error,Job 标记为 failed,并在 PR 评论中通知开发者。
1 | LLM 原始输出 |
合并进现有文档
Parser 只产出「改什么」,不直接写文件。Worker 读取磁盘上的原文件后,按 Heading 定位目标章节:
1 | // 找到 heading 段落 → 替换 |
具体来说,Worker 会用正则匹配从 ## 功能概述 到下一个同级 Heading 之间的内容:找到则替换该段 Body;找不到则在文件末尾追加新章节。
合并完成后,内容还会经过路径白名单过滤,再调用 git.applyFiles() 写入磁盘,最后 Commit 并 Push。
Commit Message 会包含 [bot:pr-doc] 标记,用于防止循环:Bot 自己的提交不会触发新一轮 Webhook。
接下来还想做什么
- 场景探索:整个 Bot 已经封装得较为通用,后续可以探索 Release Note、轻量级 CR 自动生成评论等场景。
- PR 评论交互:支持通过
@bot触发重新生成,或进行人工修正。 - 多模型支持:目前使用 DeepSeek,后续支持切换 Claude、GPT 等模型。
Jimu
请在Beep声后留言